RAG métier : transformer votre documentation en réponses fiables et vérifiables
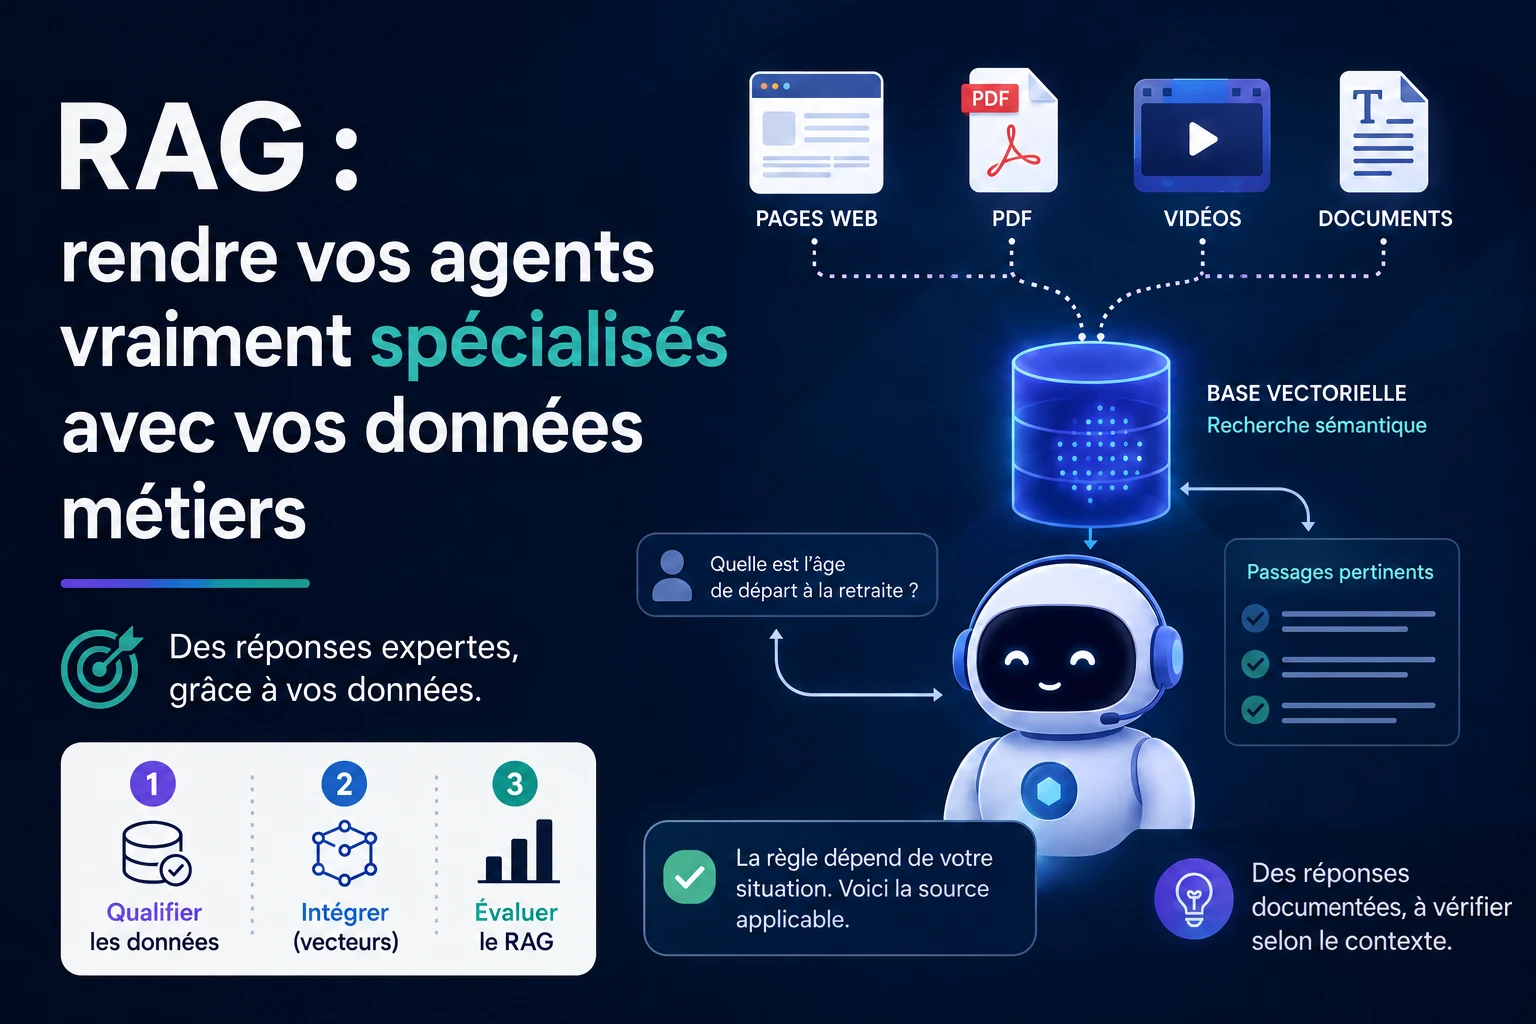
Un assistant qui connaît votre documentation peut réduire le temps passé à rechercher une procédure, retrouver une règle applicable et préparer une réponse argumentée. Encore faut-il qu’il sélectionne la bonne version du bon document, qu’il respecte les droits d’accès et qu’il sache reconnaître une information manquante. C’est sur ces points que se joue la valeur d’un RAG en entreprise.
J’ai travaillé sur ce sujet pour un acteur du secteur de la retraite. Le point de départ était favorable : des pages web déjà structurées et annotées, avec un HTML propre. Cette qualité documentaire a facilité le découpage et l’organisation des contenus. Ce retour d’expérience illustre une conviction pratique : avant de choisir une base vectorielle, il faut examiner ce que l’on va lui confier.
Le RAG apporte des sources au moment de répondre
Le Retrieval Augmented Generation associe une étape de recherche à une étape de génération. Lorsqu’un utilisateur pose une question, l’application récupère des passages pertinents et les transmet au modèle avec des consignes de réponse. Les poids du modèle ne sont pas modifiés : la connaissance métier lui est fournie dans le contexte de cette requête.
Cette distinction a une conséquence opérationnelle. Pour actualiser une procédure, on peut mettre à jour le document et son index sans réentraîner le modèle. Il faut en revanche s’assurer que l’ancienne version est bien retirée ou identifiée comme obsolète, y compris dans les caches.
Une base vectorielle facilite la recherche par proximité sémantique. Mais les noms de produits, références de contrats ou codes de procédure demandent souvent une recherche exacte complémentaire. Associer recherche lexicale et sémantique, puis réordonner les résultats, est une piste à tester selon le corpus. La présentation du Contextual Retrieval par Anthropic explique notamment l’intérêt de combiner embeddings et BM25, et de préserver le contexte des passages.
La préparation des données détermine le chantier
Dans la mission évoquée, les contenus web fournissaient déjà des limites de sections et des indications utiles au classement. On pouvait conserver la hiérarchie des titres et rattacher les passages à leur source. C’est un avantage important par rapport à une collection de fichiers dont on ignore la version, l’auteur ou le périmètre d’application.
Sur un autre corpus, le travail peut inclure la reconnaissance de texte dans des scans, la reconstitution de tableaux ou la correction de transcriptions. Un tableau mal extrait est particulièrement trompeur : le texte reste lisible, mais les montants peuvent être associés aux mauvaises lignes.
Je commencerais donc le cadrage par un échantillon représentatif des sources et des questions attendues. Cette inspection permet de distinguer les documents directement exploitables, ceux qui demandent une transformation et ceux qui nécessitent une validation métier avant ingestion. Elle donne une base plus solide au chiffrage qu’un simple nombre de fichiers.
Construire des passages qui gardent leur sens
Le découpage doit préserver les unités utiles au lecteur : une règle et ses exceptions, un titre et le paragraphe qu’il qualifie, un tableau et sa légende. Une taille fixe en tokens peut servir de limite technique ; elle ne suffit pas à définir une unité de connaissance.
Voici un contrat de données illustratif pour un passage indexé :
{
  "document_id": "procedure-exemple",
  "version": "2026-01",
  "section": "Conditions / Cas particuliers",
  "source_url": "https://documentation.example/procedure",
  "valid_from": "2026-01-01",
  "access_group": "conseillers",
  "text": "Contenu de la règle et de ses exceptions."
}
Ces métadonnées servent à citer la source, filtrer les documents et identifier ceux qui doivent être réindexés. Les droits doivent être appliqués par le service de recherche avant de transmettre les passages au modèle. Demander au LLM de ne pas révéler un document qu’il a déjà reçu serait une frontière d’accès fragile.
La chaîne d’ingestion doit également gérer les suppressions et les changements de droits. Un document retiré du référentiel ne doit pas continuer à ressortir parce que ses anciens fragments existent toujours dans l’index.
Évaluer la recherche avant d’accuser le modèle
Une réponse inexacte peut avoir plusieurs causes : la source manque, elle est mal découpée, la recherche ne la retrouve pas, ou le modèle utilise mal les passages disponibles. Changer de LLM ne traite que la dernière partie du problème.
Je distingue donc l’évaluation de la recherche de celle de la réponse. Pour une question de référence, on vérifie d’abord si les passages nécessaires figurent parmi les résultats sélectionnés. On examine ensuite si la réponse respecte ces passages, mentionne les conditions importantes et renvoie à une source réellement utile.
Les cas difficiles comptent autant que les questions courantes : procédures contradictoires, information expirée, formulation ambiguë, réponse absente du corpus. Une bonne réponse peut alors être une demande de précision ou une orientation vers un interlocuteur. Cette démarche rejoint le travail de construction d’un jeu d’évaluation métier.
Garder un budget de contexte et de latence
Une grande fenêtre de contexte ne dispense pas de sélectionner l’information. Envoyer trop de passages augmente le coût, peut ralentir la réponse et introduit des éléments concurrents. Le nombre de résultats, leur longueur et l’éventuelle étape de reclassement doivent être mesurés ensemble.
Pour dimensionner le service, je séparerais le coût initial de préparation, le coût des mises à jour et le coût par requête. Ce dernier inclut la recherche, le reclassement éventuel, la génération et les contrôles. Une documentation propre réduit le premier poste, mais l’exploitation continue doit aussi être prévue.
Sur les données sensibles, les décisions commencent avant l’indexation : quels contenus sont nécessaires, qui peut les consulter et lesquels doivent être exclus ? Les mécanismes de sécurisation d’un agent IA complètent ce travail ; ils ne remplacent pas la maîtrise du corpus.
Commencer par un périmètre qui peut être validé
Le cas du secteur de la retraite m’a montré l’intérêt d’un socle documentaire bien préparé. Pour transformer ce potentiel en service, le bon premier livrable est un périmètre évalué : des sources identifiées, des questions métier, une recherche inspectable et des réponses dont les références peuvent être vérifiées.
Votre équipe passe trop de temps à retrouver et interpréter sa documentation ? Je peux vous accompagner depuis l’audit du corpus jusqu’à l’intégration du RAG dans vos outils, avec un protocole d’évaluation adapté à vos usages. Échangeons sur vos données et vos questions métier.