Agents de développement IA : donner au projet une mémoire qui se partage
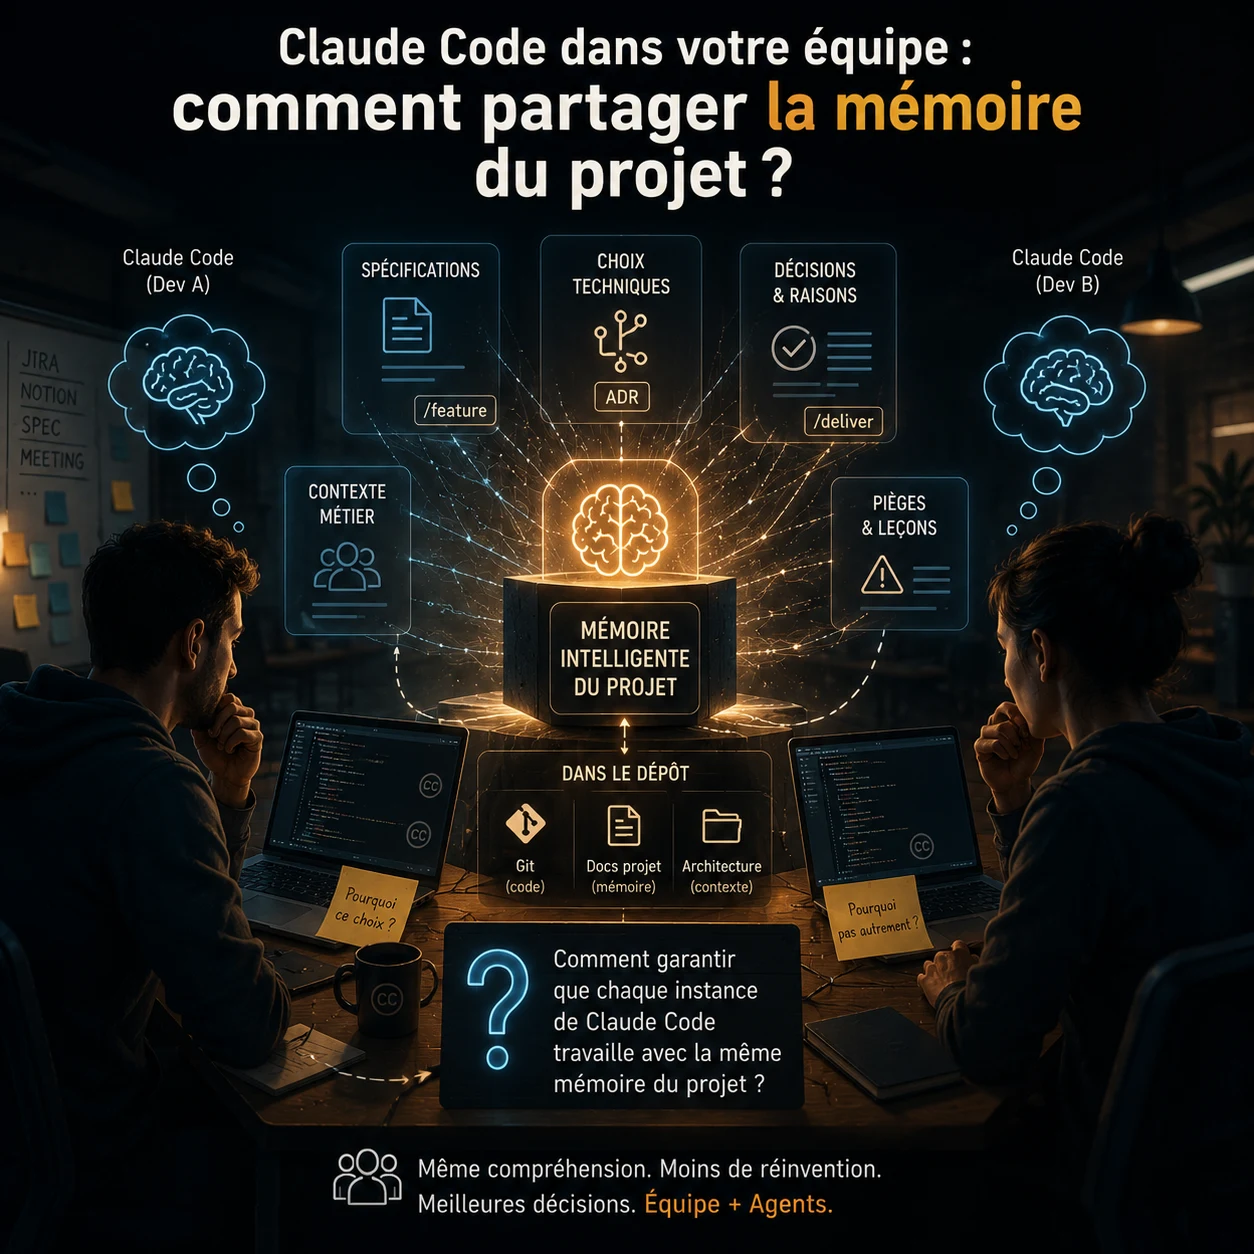
Un agent de développement peut comprendre une fonction, proposer une refonte et exécuter des tests sans connaître la contrainte qui a motivé l’architecture actuelle. Sa modification sera parfois correcte localement, mais incompatible avec une décision prise plusieurs mois plus tôt. À l’échelle d’une équipe, cette perte de contexte se paie en revues, en reprises et en discussions que l’on croyait closes.
C’est ce problème que j’ai voulu traiter en structurant une mémoire directement dans le dépôt. L’objectif est concret : permettre au prochain développeur, humain ou agent, de retrouver les raisons d’un choix avant de le remettre en cause. J’ai organisé ce fonctionnement autour de deux commandes personnalisées, /feature et /deliver, qui relient le cadrage d’une évolution à sa documentation finale.
Le contexte manquant coûte plus cher que le code généré
Git conserve l’historique des modifications. Les messages de commit et les revues peuvent aussi expliquer les décisions, à condition que quelqu’un les ait documentées. Dans la pratique, cette information est souvent dispersée : une spécification dans un outil, un arbitrage dans une conversation, une contrainte d’exploitation connue d’une seule personne.
Prenons un exemple illustratif. Une équipe conserve volontairement une file de traitement simple parce que son volume est faible et que l’exploitation doit rester accessible. Un agent découvre cette file, propose une infrastructure distribuée et produit une implémentation cohérente. Le problème n’est pas sa capacité à coder : il lui manque les critères qui permettraient d’écarter cette solution avant d’y passer du temps.
Une mémoire utile doit donc rendre accessibles quatre éléments : la décision actuelle, le problème qu’elle résout, les alternatives écartées et les conditions qui justifieraient de la réexaminer. C’est ce dernier point qui évite de transformer la documentation en interdiction permanente d’évoluer.
Séparer les règles générales des connaissances à consulter
Tout charger dans le contexte de l’agent serait une mauvaise stratégie. Un projet de plusieurs années produit trop de documents, dont une partie ne concerne pas la tâche en cours. Je préfère un point d’entrée court qui indique où chercher, puis des documents spécialisés consultés selon les modules touchés.
Claude Code propose notamment des instructions de projet dans CLAUDE.md, des règles applicables à certains chemins et des skills chargés selon le besoin. Ces mécanismes peuvent orienter la lecture ; ils ne rendent pas automatiquement une documentation exacte ou pertinente. Leur rôle et leur portée sont décrits dans la documentation des mécanismes de contexte de Claude Code.
Voici une organisation possible, à adapter à la taille du dépôt :
CLAUDE.md                  conventions et points d’entrée
docs/architecture/         fonctionnement actuel du système
docs/adr/                  décisions et raisons des arbitrages
docs/specs/                 besoin et plan de chaque évolution
docs/runbooks/              procédures d’exploitation vérifiées
Le code décrit le comportement exécutable. La documentation d’architecture décrit le système actuel. Une ADR, ou Architecture Decision Record, conserve un arbitrage et son statut. Une ancienne spec garde un intérêt historique, mais ne doit pas être prise pour une description toujours exacte du produit.
Avant de coder : retrouver les décisions pertinentes
La commande /feature que j’ai mise en place commence par explorer le contexte du projet : spécifications passées, ADR en vigueur et difficultés déjà rencontrées sur le périmètre concerné. Le cadrage qui suit bénéficie ainsi des décisions antérieures, au lieu de repartir d’une page blanche.
Je cherche à faire ressortir trois choses avant l’implémentation : ce que l’utilisateur doit pouvoir faire, les contraintes qui s’imposent à la solution et les preuves attendues pour considérer le travail comme terminé. Une spec utile relie ces trois dimensions. « Ajouter une recherche » ne suffit pas ; il faut préciser les données accessibles, les cas sans résultat et le comportement attendu quand un service est indisponible.
Cette étape garde aussi sa valeur humaine. Un agent peut proposer un arbitrage, mais une contradiction entre une nouvelle demande et une contrainte métier doit être rendue explicite. La mémoire sert à mieux poser la question, pas à choisir silencieusement à la place de l’équipe.
À la livraison : conserver ce que le diff n’explique pas
La commande /deliver intervient avant de pousser les changements. Elle documente le cheminement technique, les problèmes rencontrés, les approches abandonnées et les raisons du résultat retenu. Elle produit également une aide à la revue et vérifie la cohérence avec les décisions d’architecture.
Je distingue le fait observé de son interprétation. « Le test de reprise a échoué après une interruption » décrit une observation. « Le fournisseur ne supporte jamais les interruptions » serait une généralisation à démontrer. Une mémoire qui accumule des conclusions trop larges finit par transmettre de mauvaises contraintes aux prochaines interventions.
Un exemple illustratif de note exploitable serait :
Nous avons conservé le traitement asynchrone, car le délai du service externe dépasse celui de la requête HTTP. La reprise utilise un identifiant d’opération stable. Le scénario d’interruption a été vérifié ; le comportement sous charge reste à mesurer.
Quelques lignes suffisent ici à expliquer une décision, une conséquence technique et une limite de validation. La prochaine intervention sait où reprendre le travail.
Une mémoire partagée doit aussi être entretenue
Versionner ces documents avec le code permet de les relire dans la même revue. Cela facilite aussi la collaboration entre plusieurs agents : chacun peut retrouver le contrat d’un module sans dépendre de la conversation privée d’un collègue.
Cette approche exige cependant de l’entretien. Une décision remplacée doit être marquée comme telle. Une procédure doit renvoyer aux commandes réellement utilisées. Les résultats de tests doivent rester datés et associés au changement vérifié. Une documentation générée automatiquement mérite la même vigilance qu’un code généré automatiquement.
J’ai regroupé mes commandes, skills, agents et intégrations dans le dépôt de mon plugin Claude Code, afin de rendre cette méthode réutilisable. Le plugin donne un exemple de fonctionnement ; chaque équipe doit adapter les conventions, les droits et les critères de livraison à son propre projet.
Intégrer les agents au fonctionnement de votre équipe
Le bénéfice recherché est une meilleure continuité : moins de contraintes redécouvertes tardivement, des revues mieux orientées et des changements plus faciles à reprendre. Pour le mesurer, je regarderais notamment les retours de revue liés au contexte manquant, le temps nécessaire pour reprendre un module et la fréquence des décisions rediscutées faute de trace.
Vous utilisez déjà des agents de développement, mais leur travail reste difficile à coordonner ? Je peux vous aider à structurer les instructions de projet, la mémoire d’architecture et les étapes de livraison autour de votre codebase. Parlons de votre organisation de développement.