Observer un agent IA en production : ce que Langfuse permet de mesurer
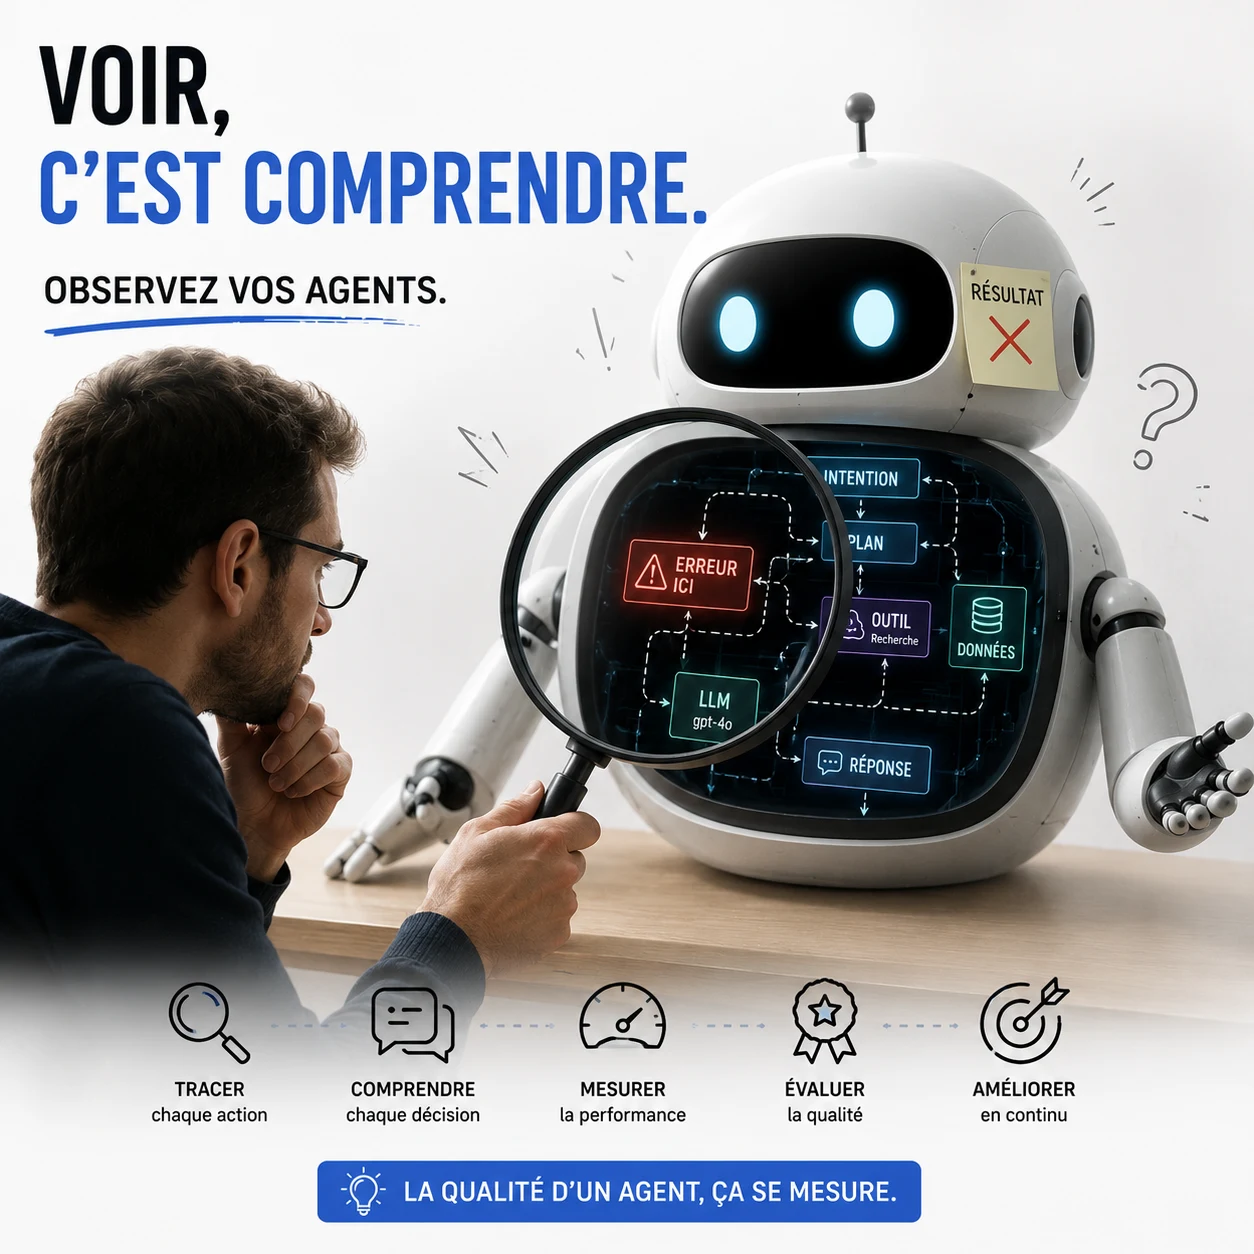
Un agent répond à côté, une requête devient lente, la facture augmente : ces trois incidents peuvent avoir la même origine, ou trois causes indépendantes. Sans traces exploitables, votre équipe doit reconstituer ce qui s'est passé à partir du message final. Elle risque alors de modifier le prompt alors que le problème vient d'un outil, du contexte documentaire ou d'une boucle de tentatives.
J'utilise Langfuse au quotidien pour rendre ces systèmes observables. Mon objectif est de pouvoir relier un comportement à une exécution précise, puis une correction à un résultat mesurable. Pour une entreprise, cela change la manière de financer les améliorations : vous pouvez choisir le chantier utile à partir de faits.
Tracer le parcours complet d'une requête
Une requête adressée à un agent peut déclencher plusieurs opérations : lecture de l'historique, recherche documentaire, génération, appel à un service métier, puis formulation de la réponse. Le résultat affiché ne raconte qu'une partie de cette histoire.
Langfuse organise l'exécution en traces et en observations imbriquées. Ces observations permettent de représenter les appels au modèle, aux outils et aux composants de recherche, avec leurs entrées, leurs sorties et leurs durées. Une session rapproche plusieurs échanges d'une même conversation. La documentation d'observabilité de Langfuse décrit ces informations et leur utilisation pour le diagnostic.
Je distingue toutefois le chemin d'exécution observable du raisonnement interne du modèle. Une trace montre le contexte transmis et les actions enregistrées. Elle aide à formuler une explication vérifiable d'un échec, mais elle ne donne pas accès à l'ensemble des mécanismes qui ont produit la réponse.
L'instrumentation doit donc couvrir les étapes sur lesquelles vous pouvez agir. Enregistrer uniquement l'appel final au LLM laisse invisibles les erreurs de récupération documentaire ou les réponses incomplètes d'un outil.
Passer d'une mauvaise réponse à une correction ciblée
Prenons un exemple fictif : un assistant de support explique à un client une procédure devenue obsolète. Plusieurs diagnostics sont possibles. Le moteur de recherche a récupéré un ancien document ; le bon extrait a été tronqué ; le modèle a ignoré une condition ; une réponse précédente est restée dans la mémoire de conversation.
Avec une trace structurée, je peux examiner les identifiants et versions des documents, les extraits effectivement transmis, les paramètres de génération et les résultats des appels métier. Chaque hypothèse appelle alors une correction différente.
Cette distinction évite de payer un modèle plus puissant pour compenser une documentation mal filtrée. Elle permet aussi d'attribuer le travail à la bonne équipe : contenu, intégration, exploitation ou développement de l'agent. C'est la même logique que pour un RAG connecté à votre documentation métier : la qualité dépend de toute la chaîne.
Pour conserver cette capacité de diagnostic après une évolution, je recommande d'associer aux traces la version de l'application, du prompt et de la configuration de recherche. Les identifiants métier utiles doivent être choisis avec parcimonie, sans recopier systématiquement les données sensibles.
Mesurer un service rendu, pas seulement des tokens
Le coût d'un appel modèle est une information utile, mais insuffisante pour piloter votre budget. Une demande peut nécessiter plusieurs appels, des reprises et l'intervention finale d'un collaborateur. Une optimisation qui réduit le prix unitaire tout en augmentant les échecs peut coûter plus cher à l'entreprise.
Je propose de rapprocher plusieurs indicateurs :
- le coût estimé d'un parcours complet, en distinguant modèles et outils ;
- le temps jusqu'à une réponse utile, avec un suivi des requêtes les plus lentes ;
- le nombre de tentatives et les erreurs techniques ;
- le taux de réussite métier, défini avec vos équipes ;
- les reprises humaines et les retours utilisateurs.
Les tokens et tarifs renseignés permettent d'estimer les dépenses de génération ; ils ne constituent pas à eux seuls une comptabilité exhaustive. Il faut notamment intégrer les autres services consommés et vérifier les écarts avec la facturation réelle.
Un indicateur global doit aussi pouvoir être décomposé par usage. Une hausse moyenne de latence peut simplement refléter l'arrivée de demandes plus complexes. Sans cette segmentation, vous risquez d'optimiser la mauvaise étape.
Auto-héberger Langfuse : comprendre les responsabilités
Langfuse est open source et peut être déployé sur votre infrastructure. Son architecture sépare l'application Web du Worker chargé des traitements asynchrones. PostgreSQL porte les données transactionnelles, ClickHouse les données analytiques, Redis ou Valkey les files et le cache, et un stockage objet conserve les événements entrants. L'ingestion écrit les événements dans ce stockage, place une référence en file, puis les traite vers ClickHouse. Ces composants sont détaillés dans la documentation d'auto-hébergement.
Ce découplage aide à absorber les variations de charge et à reprendre certains traitements. Il ne dispense pas de dimensionner les files, de surveiller leur retard, de configurer la rétention et de tester les restaurations. Une défaillance de stockage ou une mauvaise configuration restent des risques d'exploitation.
Je distingue aussi une installation locale d'une exploitation durable. Vous devez savoir qui applique les mises à jour, traite les alertes et restaure les données. L'auto-hébergement donne davantage de maîtrise ; il demande une responsabilité opérationnelle explicite.
Garder les traces utiles sans créer un second risque
Une plateforme d'observabilité peut devenir une copie très complète de vos échanges clients. Je recommande de définir les données réellement nécessaires au diagnostic avant d'activer leur collecte : catégories de contenus autorisées, masquage éventuel, accès des équipes et durée de conservation.
Conserver les traces chez vous ne signifie pas automatiquement que tous les traitements restent internes. Les appels aux modèles, les évaluateurs et les autres intégrations doivent être examinés séparément. Cette cartographie complète la sécurisation de l'agent.
Enfin, l'observabilité devient particulièrement rentable lorsqu'elle alimente une boucle d'amélioration : sélectionner les échecs intéressants, les qualifier avec le métier, les transformer en cas de test, puis vérifier les prochaines versions. C'est le lien avec l'évaluation d'un agent en production.
Avec LeoWeb, je vous accompagne pour définir cette instrumentation, intégrer les traces et construire les indicateurs qui servent vos décisions. Si votre agent fonctionne mais que ses erreurs, ses délais ou ses coûts restent difficiles à expliquer, échangeons sur votre architecture.