Agents IA : lever les blocages entre le prototype et la production
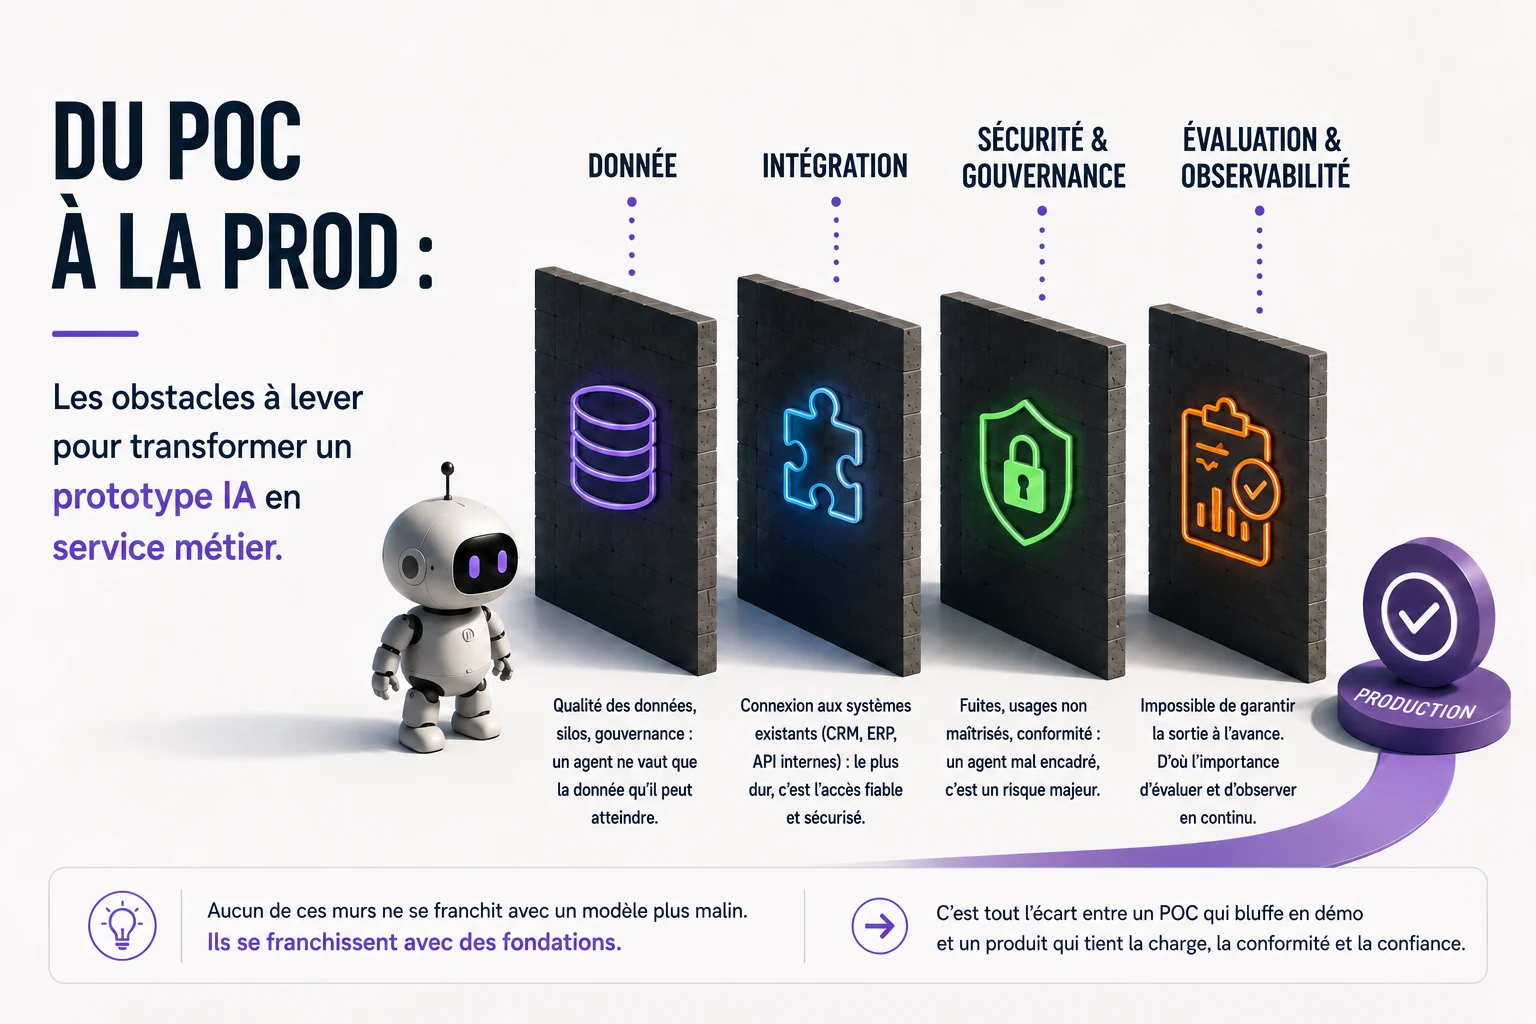
Votre prototype répond correctement en démonstration. Pourtant, l’ouverture à de vrais utilisateurs reste repoussée : les données ne sont pas toutes accessibles, les réponses difficiles à qualifier, les intégrations fragiles et les coûts encore flous. Le projet a prouvé qu’un usage était possible. Il reste à établir dans quelles conditions cet usage devient un service fiable.
C’est précisément le travail que je mène autour des applications agentiques : relier les capacités du modèle aux contraintes du système d’information et aux critères du métier. Les sujets se recoupent constamment. Une source mal versionnée devient une erreur de réponse ; un outil mal délimité devient un risque de sécurité ; une trace absente rend l’incident difficile à comprendre.
Définir une tâche dont la réussite peut être constatée
« Aider les collaborateurs » exprime une intention, mais ne donne aucun critère de livraison. « Préparer un brouillon de réponse à partir de procédures approuvées, avec les sources et une validation humaine avant envoi » définit un périmètre beaucoup plus exploitable.
Ce cadrage précise les utilisateurs, les données autorisées, les actions permises et les situations où l’agent doit s’arrêter. Il permet également de comparer le service au fonctionnement actuel : temps de recherche, reprises manuelles, qualité de la réponse et délai de traitement.
Je recommande de commencer par un flux limité et observable. Selon le besoin, une recherche documentaire suivie d’une génération peut suffire. Une boucle autonome qui choisit ses outils n’est justifiée que si cette liberté améliore effectivement le résultat. Cette distinction entre workflows prédéfinis et agents autonomes est développée dans Building effective agents d’Anthropic.
Rendre les données utilisables et accessibles au bon périmètre
Le premier obstacle est souvent moins spectaculaire que le modèle : une procédure contradictoire, une donnée sans propriétaire ou un accès différent selon les utilisateurs. Le prototype contourne facilement ces difficultés avec quelques documents sélectionnés à la main. Le service en production doit les traiter explicitement.
Pour chaque source, il faut identifier son responsable, sa fréquence de mise à jour et sa règle d’accès. Une information disponible techniquement n’est pas nécessairement autorisée pour tous les usages. Ces décisions doivent être appliquées dans les services qui alimentent l’agent.
Mon retour d’expérience sur un RAG dans le secteur de la retraite montre l’avantage d’une documentation déjà structurée. Lorsque ce socle manque, sa préparation fait partie du projet. La masquer derrière une promesse d’IA prête à l’emploi revient à déplacer le problème jusqu’au jour de l’ouverture.
Traiter les appels d’outils comme de vraies intégrations
Un agent qui consulte une API doit gérer les erreurs d’accès, les réponses incomplètes et les délais dépassés. Un agent qui modifie des données ajoute une difficulté : une relance après erreur peut répéter une opération déjà exécutée.
Prenons un exemple illustratif de création de demande dans un CRM. Si le serveur a créé la demande mais que la réponse HTTP n’arrive pas, relancer aveuglément l’appel peut produire un doublon. Une clé d’idempotence, un état d’opération consultable ou une vérification avant reprise permettent de concevoir un comportement maîtrisé. Le mécanisme exact dépend du système cible.
Chaque outil mérite donc un contrat : paramètres validés, autorisations contrôlées côté serveur, effets attendus, erreurs possibles et politique de reprise. Les identifiants du client et le périmètre de droits doivent provenir de la session authentifiée. Ils ne doivent pas être acceptés simplement parce que le modèle les a proposés.
Mesurer la qualité avant d’élargir le déploiement
Une démonstration réussie ne renseigne pas sur la diversité des cas réels. Il faut constituer un jeu de questions et de situations représentatives, validé avec les experts métier, puis le rejouer à chaque changement significatif : modèle, prompt, recherche documentaire ou définition d’outil.
Les tests déterministes vérifient les schémas, les permissions, les calculs et les effets de bord. L’évaluation des réponses examine leur exactitude, leur fidélité aux sources et leur utilité. Les juges automatiques peuvent aider à passer à l’échelle, à condition de confronter leurs notes à des appréciations humaines. Je détaille cette séparation dans l’article sur l’évaluation des agents IA.
Il faut aussi observer plusieurs exécutions lorsque la variabilité compte. Une moyenne satisfaisante peut masquer un échec rare mais bloquant. Les seuils de mise en service doivent distinguer la qualité globale des erreurs que le métier considère comme inacceptables.
Préparer l’exploitation et le retour arrière
La mise en production demande de savoir qui réagit lorsqu’un service externe échoue, qu’un coût augmente ou qu’une réponse est signalée comme incorrecte. Les traces doivent permettre de relier la demande, les sources utilisées, les outils appelés et la version du système, tout en limitant les données sensibles enregistrées.
Un déploiement progressif permet de confronter le service à des usages réels sur un périmètre contrôlé. On peut commencer par des recommandations à valider, puis élargir les actions autorisées lorsque les résultats le justifient. Le retour au traitement manuel et la désactivation d’un outil doivent être prévus avant l’incident.
Le coût mérite la même précision. Le prix d’un appel modèle ne représente qu’une partie du service : relances, évaluations, recherche, stockage des traces, hébergement et intervention humaine comptent aussi. Je regarderais le coût par tâche utilement terminée, accompagné d’indicateurs de qualité et de délai, plutôt qu’un coût moyen par token isolé.
Organiser le passage en production autour de livrables concrets
Pour rendre ce travail pilotable, je propose de relier chaque risque à une preuve attendue :
| Chantier | Livrable utile à la décision |
|---|---|
| Cadrage | Cas d’usage, limites et critères de réussite validés |
| Données | Sources identifiées, règles d’accès et mises à jour définies |
| Intégrations | Contrats d’outils et scénarios d’échec vérifiés |
| Qualité | Jeu d’évaluation versionné et résultats comparables |
| Exploitation | Traces, alertes, responsables et procédure de retour arrière |
Ce travail peut révéler qu’un prototype doit être simplifié, qu’une intégration manque ou qu’un corpus doit être préparé avant d’aller plus loin. C’est une information utile pour investir au bon endroit. Ajouter un modèle plus puissant sans ce diagnostic risque surtout d’augmenter le coût d’un problème inchangé.
Votre agent fonctionne en démonstration, mais la mise en production reste bloquée ? Je peux auditer le parcours complet, identifier les obstacles et construire avec votre équipe un plan d’industrialisation vérifiable. Parlons de votre prototype et de ce qui manque pour l’exploiter.